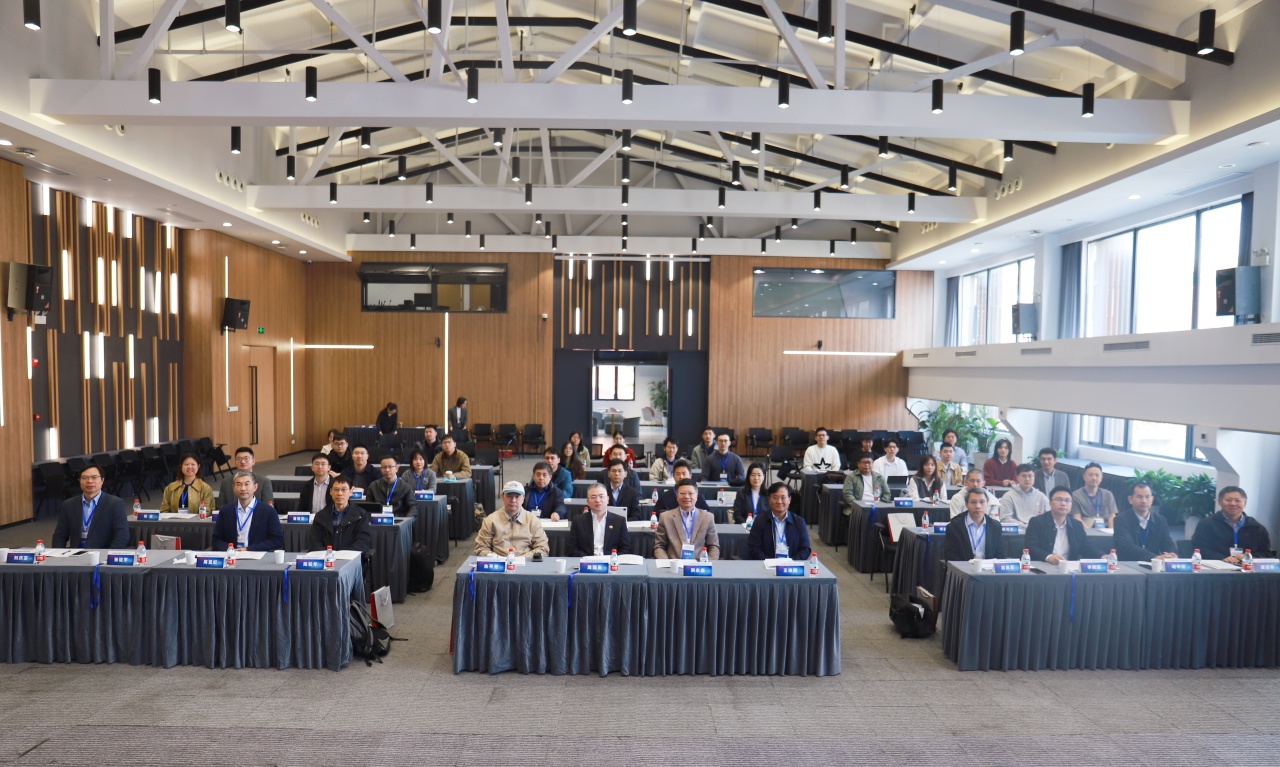
开幕式上,上海财经大学党委副书记周国良,数理经济学教育部重点实验室(上海财经大学)主任周亚虹教授分别致辞,对与会专家学者表示热烈欢迎。
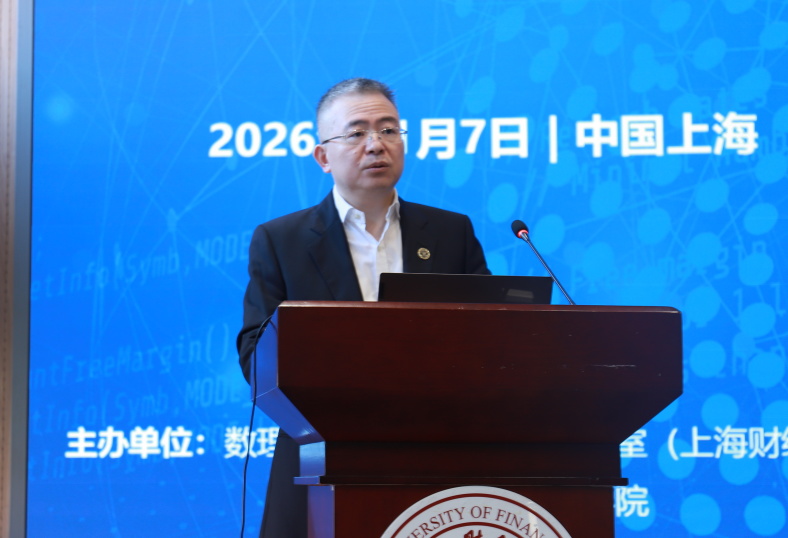
周国良副书记指出,人工智能正深刻改变经济学的数据生产方式、研究范式与政策环境,期待与会学者围绕人工智能与计量经济学的交叉融合充分研讨、碰撞思想,共同推动计量经济学的理论创新与学科发展。
周亚虹教授对参会专家表示感谢,同时介绍了数理经济学教育部重点实验(上海财经大学)在人工智能与计量经济学交叉学科发展的支持措施与近期成果。
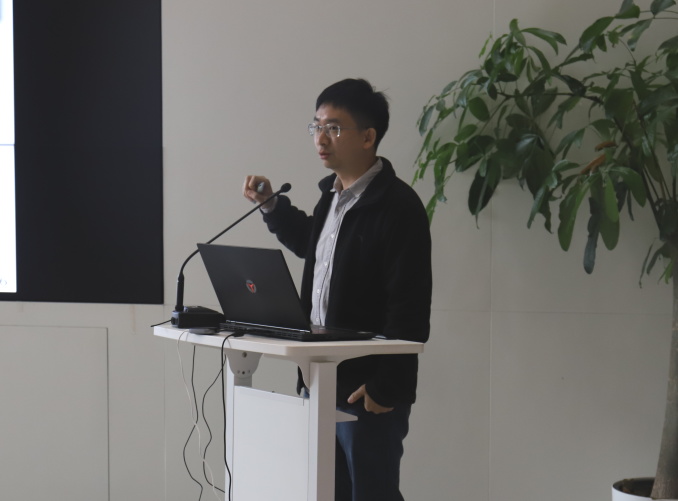
发展中国家科学院院士、中国科学院大学洪永淼教授提出基于实时频率分解的最优预测组合方法,建立相应的大样本理论,并将方法拓展至机器学习预测模型,以汇率预测为例展示了方法的实际表现。
世界计量经济学会会士、浙江大学陈松年教授针对连续时间模型中时点波动率不可观测的问题,构造自适应加权的偏差修正非线性最小二乘估计量,证明其达到效率界,模拟显示估计精度大幅提升,并讨论了模型误设定情形下的推断与设定检验,应用于外汇市场实证研究。
清华大学苏良军教授研究存在弱因子情形下因子个数的检验问题,提出基于边缘回归估计Tracy-Widom尺度参数的新检验方法,建立渐近理论,并通过模拟考察其有限样本表现,方法还可推广至更一般的数据生成过程。
首都经济贸易大学李鲲鹏教授研究面板数据模型中未知共同突变点的估计与推断问题,允许突变同时发生在个体固定效应、斜率系数与个体异方差之中。
厦门大学姜富伟教授报告了将企业特征数值信息嵌入企业序列的生成式人工智能方法N-BERT,利用注意力机制学习企业间关联结构并预测股票横截面收益,其风险调整后表现明显优于直接使用企业特征的常用机器学习基准。
两场主旨报告分别由东北财经大学统计学部主任、原副校长王维国教授和山东财经大学党委副书记谢申祥教授主持。
左右滑动查看更多
两场特邀报告平行举行。湖南大学李海奇教授针对能够刻画尾部损失强度差异的极端分位数(extremile)回归,提出数据富集环境下的最优模型平均方法,建立渐近理论并将其拓展到高维情形;武汉大学刘成教授利用高频数据刻画波动率的粗糙性,提出周期分形拟极大似然方法用于积分波动率预测;广西大学何心巨副教授针对以大语言模型测量核心解释变量时的非经典测量误差问题,提出共享偏差因子模型,利用多模型、锚定样本与文本特征三类信息实现参数识别与统计推断;中山大学杨海生教授在Acemoglu-Azar内生生产网络模型基础上引入劳动要素约束,识别人工智能产业并重构投入产出表,研究发现人工智能部门虽规模尚小但扩张迅猛,已成为生产网络的重要枢纽;浙江财经大学潘哲文副教授针对协变量数远超样本量的超高维加速失效时间模型,提出自适应正则化的秩估计方法,证明其具有Oracle性质,并通过模拟与乳腺癌基因表达数据验证了方法的优势。
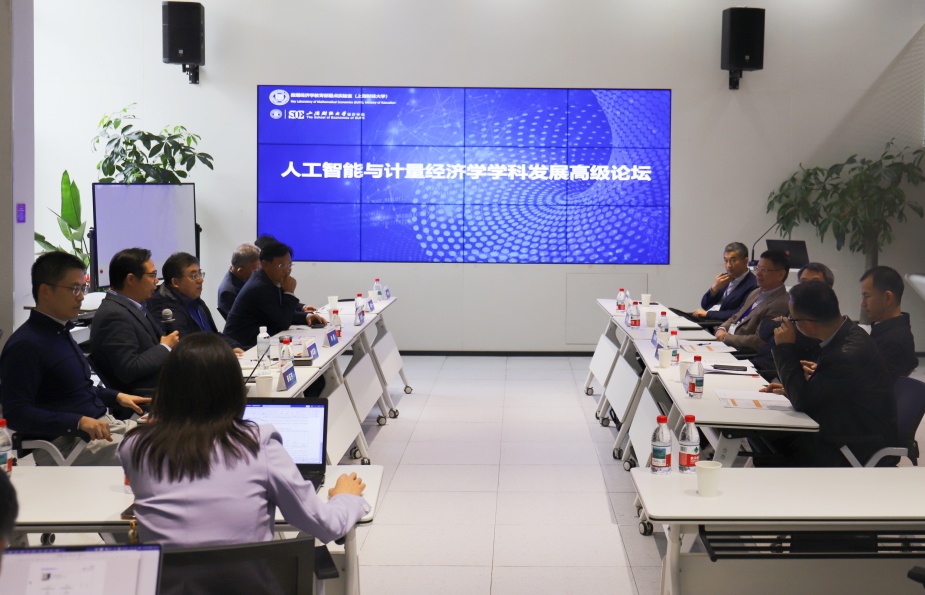
陈诗一、王维国、谢申祥、孙巍、刘庆富、肖强等与会专家与作主旨报告的专家洪永淼、陈松年、苏良军、李鲲鹏、姜富伟等围绕人工智能时代的计量经济学研究与人才培养展开讨论。大家认为,计量经济学研究者应主动将人工智能融入研究与教学,同时坚守问题选择、模型设定、结果核验与经济解释的学术责任;教学应更加突出数学与计量原理,着力培养学生发现问题、识别因果和判断结果的能力;应依托“101”教材和高校联盟推进学科教育与人工智能的融合,共建可供推广的本科教学案例。与会专家提醒到,应关注过度依赖人工智能对独立思考、原创性和审稿质量的影响,学术期刊如何判断人工智能生成稿件、高校课程如何具体调整,仍需在实践中进一步探索。
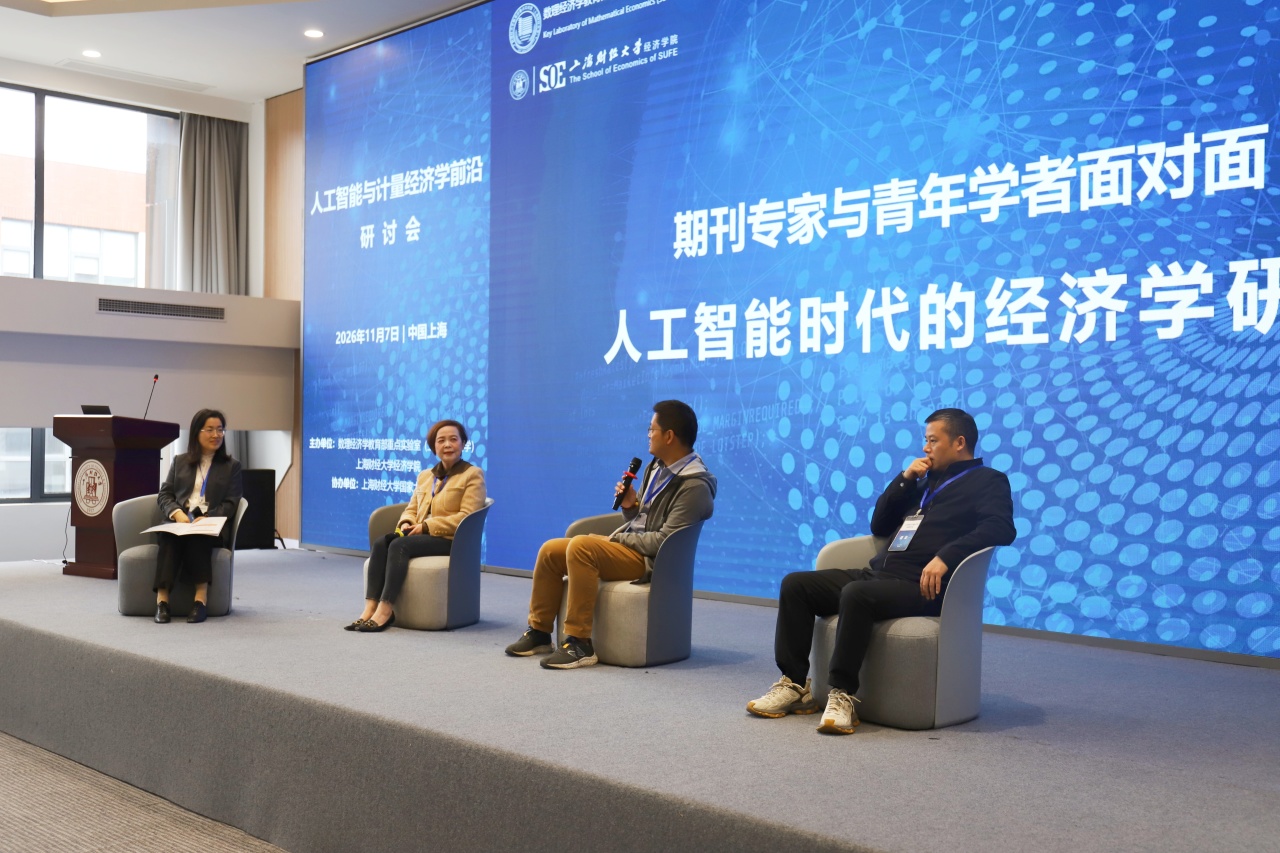
《学术月刊》沈敏编审、上海社会科学院盛垒教授、复旦大学李志远教授等期刊专家与东北财经大学张军、南开大学张健、上海海关学院陈一飞、嘉兴大学周艳、宁波大学萧莘玥、浙江财经大学曹思力等青年学者,就人工智能时代经济学研究的选题、写作与发表进行交流。他们鼓励青年学者在用好人工智能工具的同时要保持问题意识与学术原创性。
数理经济学教育部重点实验室(上海财经大学)成员报告了人工智能与计量经济学结合的最新研究成果。张征宇、杨凯、刘鸿宇利用大语言模型辅助的主题模型,分析1980年以来计量经济学方法的演化;周亚虹、韩懿扬基于大语言模型识别的平台经济劳动争议裁判文书,考察平台经济规范对劳动者权益司法保护的影响;陈强、宋欣怡、阳俊辉提出衍生品环境下分布稳健动态投资组合选择的半解析DeepHJB方法;范馨月、严舟珣从央行沟通的时态特征切入,研究信息异质性、预期管理与宏观经济调控之间的关系。
供稿 | 杨凯、王昕嘉(学)
供图 | 林庭萱(学)
编辑 | 杜雨晴
审核 | 燕红忠